Sie bringen die Frage mit.
Ziehen Sie Ihre Datendatei in OptiMod. Legen Sie Ihr Ziel und Ihre Variablen fest. Sie bringen den Kontext und Ihr Fachwissen ein; Programmier- oder Statistikkenntnisse sind nicht erforderlich.
OptiMod automatisiert wissenschaftliche Datenanalyse und macht aus komplexen Daten klare, belastbare Erkenntnisse. Verstehen Sie die Ergebnisse, ihre Unsicherheit und ihre Begründung – für Entscheidungen in Forschung, Wirtschaft und Politik.

Bereinigter Zusammenhang für leichten Regen oder Schnee im Vergleich zu klarem Wetter.
95%-Konfidenzintervall · 38%–60% geringer
Wissenschaftliche Datenanalyse sollte allen offenstehen.
Organisationen sammeln mehr Daten, als ihre Statistikspezialisten auswerten können. OptiMod macht dieses Fachwissen als Software zugänglich, damit Forschende und Fachteams ihren eigenen Fragen nachgehen können.
Allgemeine KI-Sprachmodelle ersetzen kein wissenschaftliches Validierungssystem. OptiMod prüft die Daten und Modellannahmen, vergleicht geeignete Verfahren und dokumentiert die Berechnungen hinter jeder Erkenntnis.
Ziehen Sie Ihre Datendatei in OptiMod. Legen Sie Ihr Ziel und Ihre Variablen fest. Sie bringen den Kontext und Ihr Fachwissen ein; Programmier- oder Statistikkenntnisse sind nicht erforderlich.
Datenaufbereitung, Verfahrensvoraussetzungen, Annahmenprüfung, Modellvergleich und Analyse – alles läuft automatisch, mit dokumentierter Begründung.
Verstehen Sie die Ergebnisse und ihre Unsicherheit. Der Wissenschaftliche Bericht hält die Methoden, konkreten Tests und analytischen Entscheidungen hinter dem Ergebnis fest.
OptiMod verbindet mathematisch-logische Berechnungen mit gezielter KI-Unterstützung. Es prüft Ihre konkreten Daten und die Voraussetzungen möglicher Verfahren und wählt das Modell, das für Ihre Frage am besten durch die Daten gestützt wird. Automatisch.
OptiMod untersucht Datenqualität, Variablentypen, Verteilungen und Zusammenhänge. Es bereitet den Datensatz auf und dokumentiert jede Änderung.
Mathematisch-logische Prüfungen ermitteln, welche Verfahren zu den Daten und zur Fragestellung passen. Modellannahmen sind von Beginn an Teil dieser Bewertung.
OptiMod vergleicht geeignete Modelle anhand von Modellgüte, diagnostischen Befunden und Analyseziel. Die Auswahl wird wissenschaftlich begründet und dokumentiert.
Schätzungen, Unsicherheit und Interpretation bleiben mit den zugrunde liegenden Berechnungen verbunden. Jede Erkenntnis lässt sich auf ihre Daten, Methoden und Prüfungen zurückführen.
der befragten Forschenden hatten erfolglos versucht, Experimente anderer Forschender zu reproduzieren.
Befragung von 1,576 Forschenden · Nature, 2016Unser Ziel ist, wissenschaftliche Prüfung zur Routine zu machen. Wenn statistisches Fachwissen direkt im Analyseprozess verfügbar ist, gelangen Forschende vom Experiment zum Ergebnis – mit den Nachweisen, die eine wissenschaftliche Begutachtung benötigt.
Forschende erhalten Zugang zu den statistischen Prüfungen, die ihre Arbeit erfordert – auch wenn ihrem Lehrstuhl nur wenige Spezialisten zur Verfügung stehen.
Forschungspartner und Gutachter können Annahmen, Unsicherheit und die Begründung eines Befunds prüfen und beurteilen, welche Schlussfolgerungen die Evidenz trägt.
Der Wissenschaftliche Bericht verbindet jede Erkenntnis mit den zugehörigen Analyseentscheidungen. Andere Teams können die Arbeit nachvollziehen und als Grundlage für weitere Forschung nutzen.
Mathematisch-logische Prüfungen ermitteln, welche Verfahren zu den Daten passen. Diagnostische und statistische Befunde begründen die Modellauswahl.
KI macht den Prozess effizienter und die Ergebnisse verständlich. Erklärungen bleiben mit den zugrunde liegenden Berechnungen und Prüfungen verbunden.
Ziehen Sie Ihre Datendatei in OptiMod und legen Sie Ihr Ziel fest. OptiMod übernimmt die wissenschaftliche Analyse automatisch, erklärt die Ergebnisse und dokumentiert, wie sie zustande kommen.
Analyse der täglichen NachfrageBeispieldatensatzZiehen Sie Ihren Datensatz hierher. Keine Programmier- oder Statistikkenntnisse erforderlich.
CSV, Excel & mehr · hier beginnt Ihre Analyse
✓ 731 Datenzeilen erkannt · Quelldatei erhaltenProbieren Sie es aus: Ziehen Sie die Beispieldatei hierher oder wählen Sie sie per Klick aus.| Datum | Tägliche Fahrten | Wetter |
|---|---|---|
| 01. Jan. 2011 | 985 | Nebel / bewölkt |
| 02. Jan. 2011 | 801 | Nebel / bewölkt |
| 03. Jan. 2011 | 1,349 | Klar |
Drei Zeilen des ursprünglichen öffentlichen Datensatzes. Ihre Quelldatei bleibt unverändert.
Wählen Sie aus, was erklärt und welche Variablen berücksichtigt werden sollen. OptiMod bestimmt das statistische Vorgehen.
Wie hängt das Wetter
mit der Bike-Sharing-Nachfrage zusammen?
OptiMod prüft die Daten und Verfahrensvoraussetzungen, vergleicht geeignete Modelle und berechnet die Ergebnisse.
731 Datenzeilen geprüft. Spalten mit Zielwert-Leakage und redundante Spalten ausgeschlossen.
Zähldatenmodelle anhand der Daten und diagnostischen Befunde verglichen.
Konfidenzintervalle, Sensitivitätsprüfungen und verbleibende Grenzen dokumentiert.
Das Wetter hängt mit der täglichen Nachfrage zusammen, auch unter Berücksichtigung weiterer Variablen.
Geschätzter Zusammenhang in diesem Datensatz.
95%-Intervall: 38%–60% geringer.
Modellbasierter Vergleich bei konstant gehaltenen weiteren Variablen. Klares Wetter = 100.
Dies ist ein Zusammenhang, kein Nachweis von Ursache und Wirkung. Modellgrenzen bleiben Teil der Analyse.
Von Modellannahmen bis zu konkreten statistischen Tests: die wissenschaftliche Dokumentation hinter Ihrem Ergebnis.
WISSENSCHAFTLICHER BERICHTDaten. Methoden. Evidenz.
Fragestellung, Quelldaten und Aufbereitung.
Testnamen, Teststatistiken, p-Werte und Interpretation.
Ergebnisse, Unsicherheit und Grenzen.
Bewahren und teilen Sie die Dokumentation unabhängig vom Zugang zu OptiMod.
Laden Sie Ihre Daten hoch. Sobald Sie das Ziel festlegen, übernimmt OptiMod die wissenschaftliche Analyse.
Echte öffentliche DatenVorschau der Benutzeroberfläche in der abschließenden Entwicklung. Das Beispiel verwendet echte öffentliche Daten und unabhängig berechnete Ergebnisse. Die Wiedergabe veranschaulicht den Ablauf von Analyse und Berichtexport.
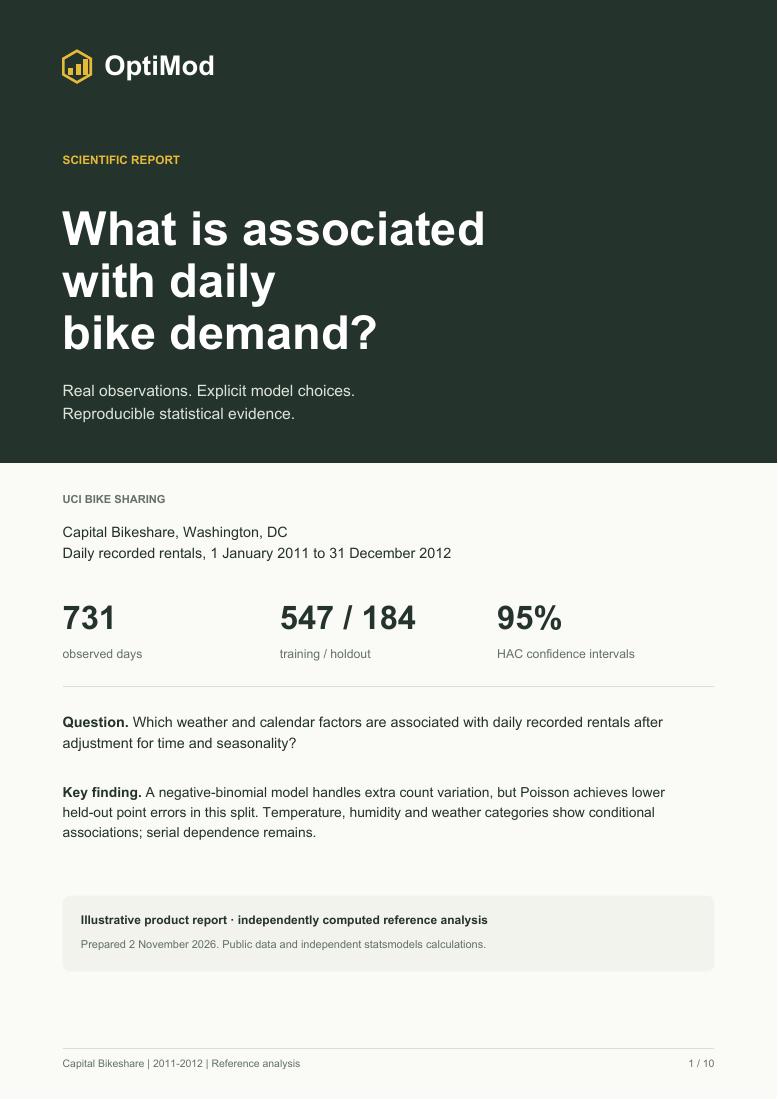
731 Tage erfasster Bike-Sharing-Nachfrage in Washington, DC, von Januar 2011 bis Dezember 2012.
Die Vorschau verwendet verständliche Spaltenbezeichnungen. Die herunterladbare CSV-Datei behält die ursprünglichen Namen und normierten Einheiten bei.
Original-CSV herunterladenEine erklärende Analyse bedingter Zusammenhänge anhand beobachteter täglicher Wetter- und Kalenderdaten.
cnt · tägliche Anzahl der Ausleihencasual und registered addieren sich bereits zur Zielvariable; instant ist eine Kennung; atemp enthält redundante Temperaturinformationen.Fragestellung und Konfiguration sind für dieses Beispiel festgelegt. Es handelt sich weder um eine Prognose anhand zukünftigen Wetters noch um eine Schätzung kausaler Effekte.
Die Prüfungen machen wissenschaftliche Entscheidungen nachvollziehbar. Auch Befunde, die eine Beurteilung erfordern, bleiben sichtbar.
Alle 731 Zeilen bleiben erhalten. Fehlende Werte werden nicht imputiert, Ausreißer nicht stillschweigend entfernt. Zwei Spalten mit Zielwert-Leakage und eine redundante Temperaturvariable werden ausgeschlossen.
Ein Luftfeuchtigkeitswert ist null (10. März 2011). Er wird markiert; zur Sensitivitätsprüfung wird die Analyse ohne ihn wiederholt. Wegen widersprüchlicher Archivmetadaten bleibt die Temperatur in den normierten Quelleinheiten.
Poisson und Negative Binomial (NB2) werden an 547 Trainingstagen angepasst. Der Trainings-AIC beträgt 66,197.6 für Poisson und 8,815.7 für NB2. Die Poisson-Dispersion beträgt 109.20 und zeigt eine deutlich höhere Streuung als unter der Varianzannahme des Modells.
Für die Zusammenhangsanalyse wird NB2 gewählt. Im zurückgehaltenen 184-Tage-Testdatensatz hat Poisson den geringeren Prognosefehler: 689 gegenüber 863 Fahrten/Tag. Die Modellauswahl richtet sich nach der Fragestellung; es gibt keinen universellen Sieger.
Die Koeffizientenintervalle verwenden eine HAC-Kovarianzschätzung mit 7 Verzögerungen. Die Residuenkorrelation bei Verzögerung 1 bleibt bei 0.387; diese Anpassung beseitigt die Modellgrenzen nicht. Wetterkategorie 3 umfasst nur 21 Tage. Studiendesign, Messung und Übertragbarkeit auf andere Kontexte müssen weiterhin geprüft werden.
Leichter Regen oder Schnee geht in diesem Datensatz mit einer um 50.4% niedrigeren erwarteten täglichen Anzahl als bei klarem Wetter einher, unter Berücksichtigung der einbezogenen Variablen.
Die Grafik zeigt bereinigte Zählratenverhältnisse, nicht die unbereinigte durchschnittliche Nachfrage. Die Schätzung für Nebel/bewölkt beträgt 0.910. Diese explorativen Zusammenhänge sind nicht für multiples Testen korrigiert und belegen keine Kausalität.
Der Prognosefehler im Testdatensatz wird mit einem an den ersten 547 Tagen angepassten Modell ermittelt. Für NB2 beträgt der MAE 863 Fahrten/Tag und der RMSE 1,123; Poisson hat einen niedrigeren MAE von 689. Die 184 zurückgehaltenen Tage verwenden das tatsächlich beobachtete Wetter, keine Wettervorhersagen.
Ein exaktes Berechnungsprotokoll: die geprüfte Frage, das verwendete Verfahren, sein numerisches Ergebnis und die Interpretation.
| Frage / Annahme | Test oder Diagnose | Ergebnis |
|---|---|---|
| Autokorrelation der Residuen bis zu 7 täglichen Verzögerungen | Ljung–Box Q df = 7 | Q = 251.9104 p = 1.0863 × 10−50 Abhängigkeit festgestellt |
| Autokorrelation der Residuen bis zu 14 täglichen Verzögerungen | Ljung–Box Q df = 14 | Q = 258.9912 p = 3.9574 × 10−47 Abhängigkeit festgestellt |
| Sind die Koeffizienten des Mittelwertmodells schätzbar? | Rang der Designmatrix | 26 von 26 Spalten Voller Rang · kein p-Wert |
| Passt die Poisson-Varianzannahme zur beobachteten Streuung? | Pearson-Dispersion Trainingsmodell | 109.20 Deutliche Überdispersion · Diagnose, kein formaler Test mit p-Wert |
Die Ljung–Box-Nullhypothese besagt, dass bis zur angegebenen Verzögerung keine Residuenautokorrelation vorliegt. Beide Referenzprüfungen weisen auf verbleibende Abhängigkeit hin. Hier dienen sie als beschreibende Residuenprüfungen mit model_df = 0, nicht als abschließende Tests der NB2-Modellspezifikation.
Für die Unsicherheit der Koeffizienten wird eine HAC-Kovarianzschätzung mit sieben Verzögerungen verwendet. Sie beseitigt weder die Abhängigkeit noch garantiert sie eine korrekte Modellspezifikation. Der Bericht hält diesen Befund zusammen mit der Modellauswahl und den Ergebnissen fest.
Der Wissenschaftliche Bericht dokumentiert die Modellauswahl, die geprüften Annahmen und die Unsicherheit hinter dem Ergebnis. Bewahren und teilen Sie das PDF unabhängig vom Zugang zu OptiMod.
Enthält Quelldaten, Analysecode und Versionen der verwendeten Abhängigkeiten.
Einzelne Nutzer erhalten Zugang zu wissenschaftlicher Analyse, ohne statistisches Fachwissen zu benötigen. Plattformanbieter können dieselbe Fähigkeit in Software, Datenprozesse und KI-Systeme integrieren.
Laden Sie Ihre Daten hoch und legen Sie Ihr Ziel fest. OptiMod übernimmt die statistische Arbeit automatisch, prüft Daten und Verfahrensvoraussetzungen und wählt eine geeignete Analyse. Sie erhalten verständliche Ergebnisse und einen Wissenschaftlichen Bericht.
Ihre Analyse
Verstehen, was meine Zielgröße beeinflusst.
Datenaufbereitung, Annahmenprüfung und evidenzbasierte Modellauswahl.
Was die Ergebnisse bedeuten, wie sicher sie sind und was zu beachten ist.
Verbinden Sie den wissenschaftlichen Kern von OptiMod mit Analyseplattformen, Unternehmenssoftware, Forschungssystemen und KI-Assistenten. Integrieren Sie automatisierte Analysen und nachvollziehbare Erkenntnisse in Ihre eigenen Produkte und Prozesse.
Forschung, Unternehmen und öffentliche Institutionen treffen unterschiedliche Entscheidungen. Sie alle benötigen Analysen, deren Methoden, Unsicherheit und Grenzen nachvollziehbar sind.
Machen Sie aus experimentellen Daten wissenschaftlich fundierte Erkenntnisse. OptiMod übernimmt Modellbewertung, statistische Prüfungen und Interpretation – mit einer klaren Analysedokumentation für Forschungspartner und Publikationen.
Strukturieren Sie explorative Analysen und priorisieren Sie Hypothesen für weitere Untersuchungen. Pharma Intelligence bietet dafür einen aktiven Forschungskontext.
Vergleichen Sie Erklärungen, untersuchen Sie Unsicherheit und beziehen Sie dokumentierte Evidenz in die Unternehmensplanung ein.
Erkennen Sie untersuchenswerte Zusammenhänge und geben Sie technischen Teams eine gemeinsame statistische Grundlage für Prozessbewertungen.
Analysieren Sie Hochwasserexposition, die Verletzlichkeit der Bevölkerung und Infrastrukturdaten als Grundlage nationaler Investitionsprioritäten. Machen Sie Annahmen, Unsicherheit und Begründung jeder Schlussfolgerung transparent – damit Entscheidungen über Menschenleben, kritische Infrastruktur und öffentliche Mittel geprüft und erklärt werden können.
Dokumentieren Sie Schätzungen, Modellauswahl und Unsicherheit, damit analytische Schlussfolgerungen intern geprüft werden können.
Integrieren Sie Verfahrensbewertung, Annahmenprüfung und dokumentierte statistische Ergebnisse in die Software, die Menschen bereits nutzen. Geben Sie ihnen eine verständliche Erklärung samt wissenschaftlicher Dokumentation.
OptiMod ist aus dem ITE der Leibniz Universität Hannover hervorgegangen. Heute leitet es Pharma Intelligence und verbindet wissenschaftliche Softwareentwicklung mit KI-gestützter pharmazeutischer Forschung.

Gegründet von den Brüdern Ylli und Drini Morina, die Unternehmensentwicklung und quantitative Forschung in einem Team verbinden.
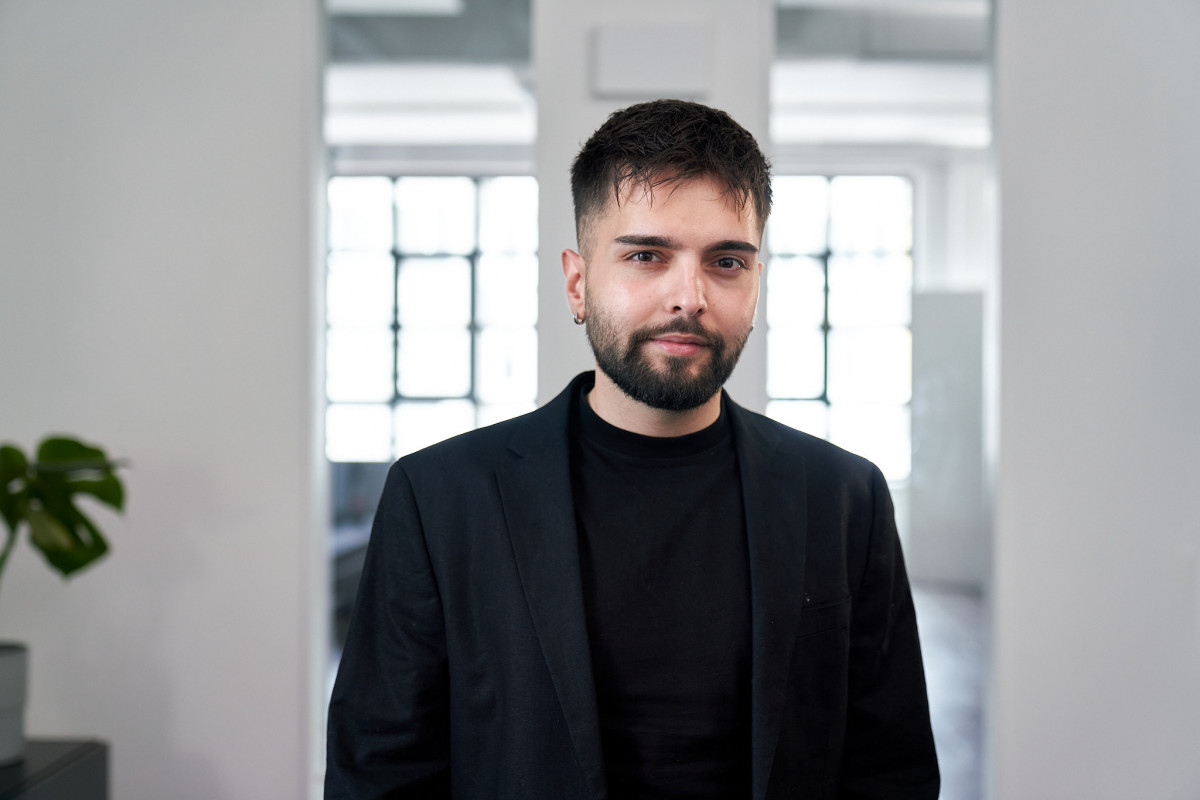
Studierte Informatik an der Georg-August-Universität Göttingen. Er verantwortet OptiMods Unternehmensentwicklung und strategische Partnerschaften und entwickelt aus der wissenschaftlichen Grundlage ein klares Produkt und Geschäftsmodell.
Kontakt zum Team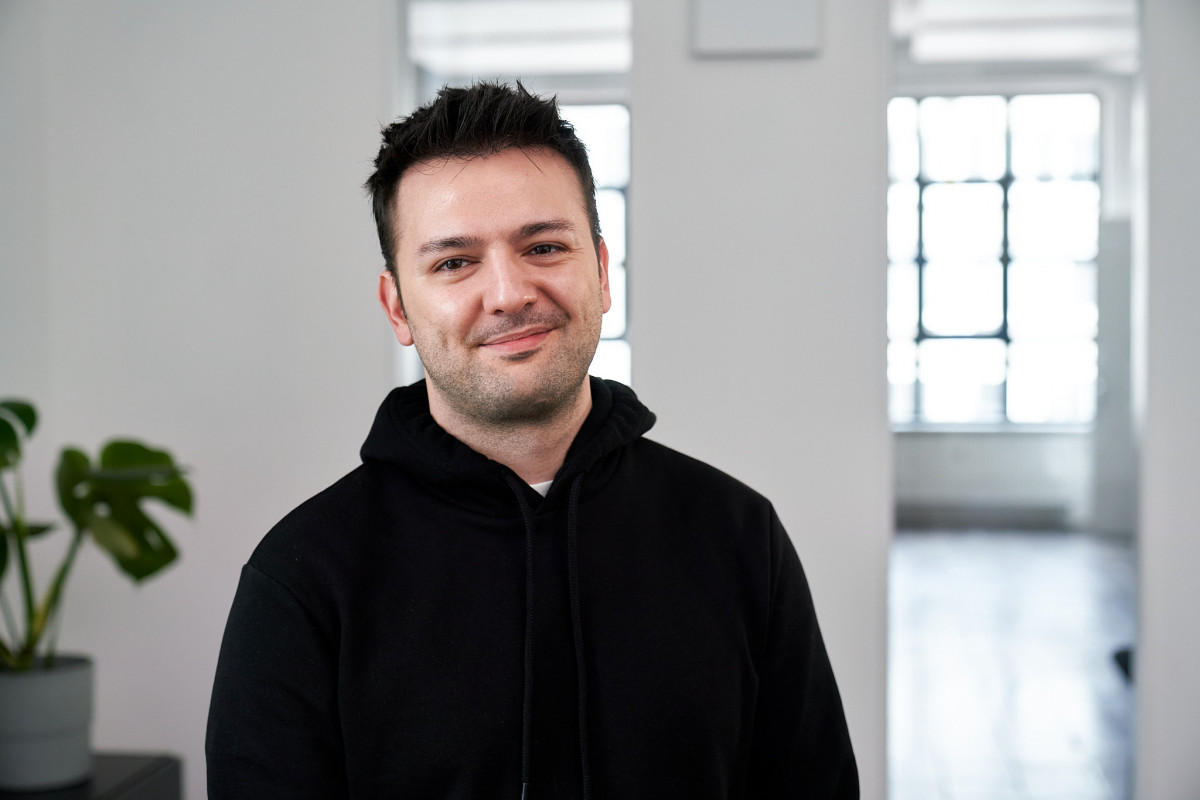
Studierte Statistik an der Georg-August-Universität Göttingen und forscht an der Leibniz Universität Hannover. Seine Arbeit verbindet Data Science, Innovationsforschung und statistische Methodik.
Wissenschaftlicher HintergrundFür Institutionen mit hohen Anforderungen an Datenschutz, Sicherheit und Datenhoheit. OptiMod ermöglicht Hosting in Deutschland und den vollständigen Betrieb auf der eigenen Infrastruktur Ihrer Organisation.
Institutionelle Anforderungen besprechenHosting in Deutschland, mit DSGVO-konformer Datenverarbeitung. Für Institutionen mit hohen Anforderungen an Datenschutz, Sicherheit und die Kontrolle über ihre Daten.
Ihre Daten werden niemals zum Training von KI-Modellen verwendet. Nach Abschluss der Analyse werden die zur Berechnung der Ergebnisse verwendeten Daten von den Servern gelöscht.
OptiMod kann auf Ihren eigenen Servern oder Rechnern betrieben werden. In sensiblen Einsatzbereichen bleiben Analyse und Daten vollständig innerhalb Ihrer eigenen Infrastruktur.